Cita de la fuente A chatbot user waiting 4.4 seconds for the first token now sees it in under 800 ms.
AWS Machine Learning Blog Estado de evidencia: Las afirmaciones materiales incluidas fueron contrastadas con la evidencia enlazada.
AWS ataca el desperdicio de GPU en inferencia con una capa de enrutamiento que, si cumple sus números, mejora la experiencia y reduce el costo por solicitud.
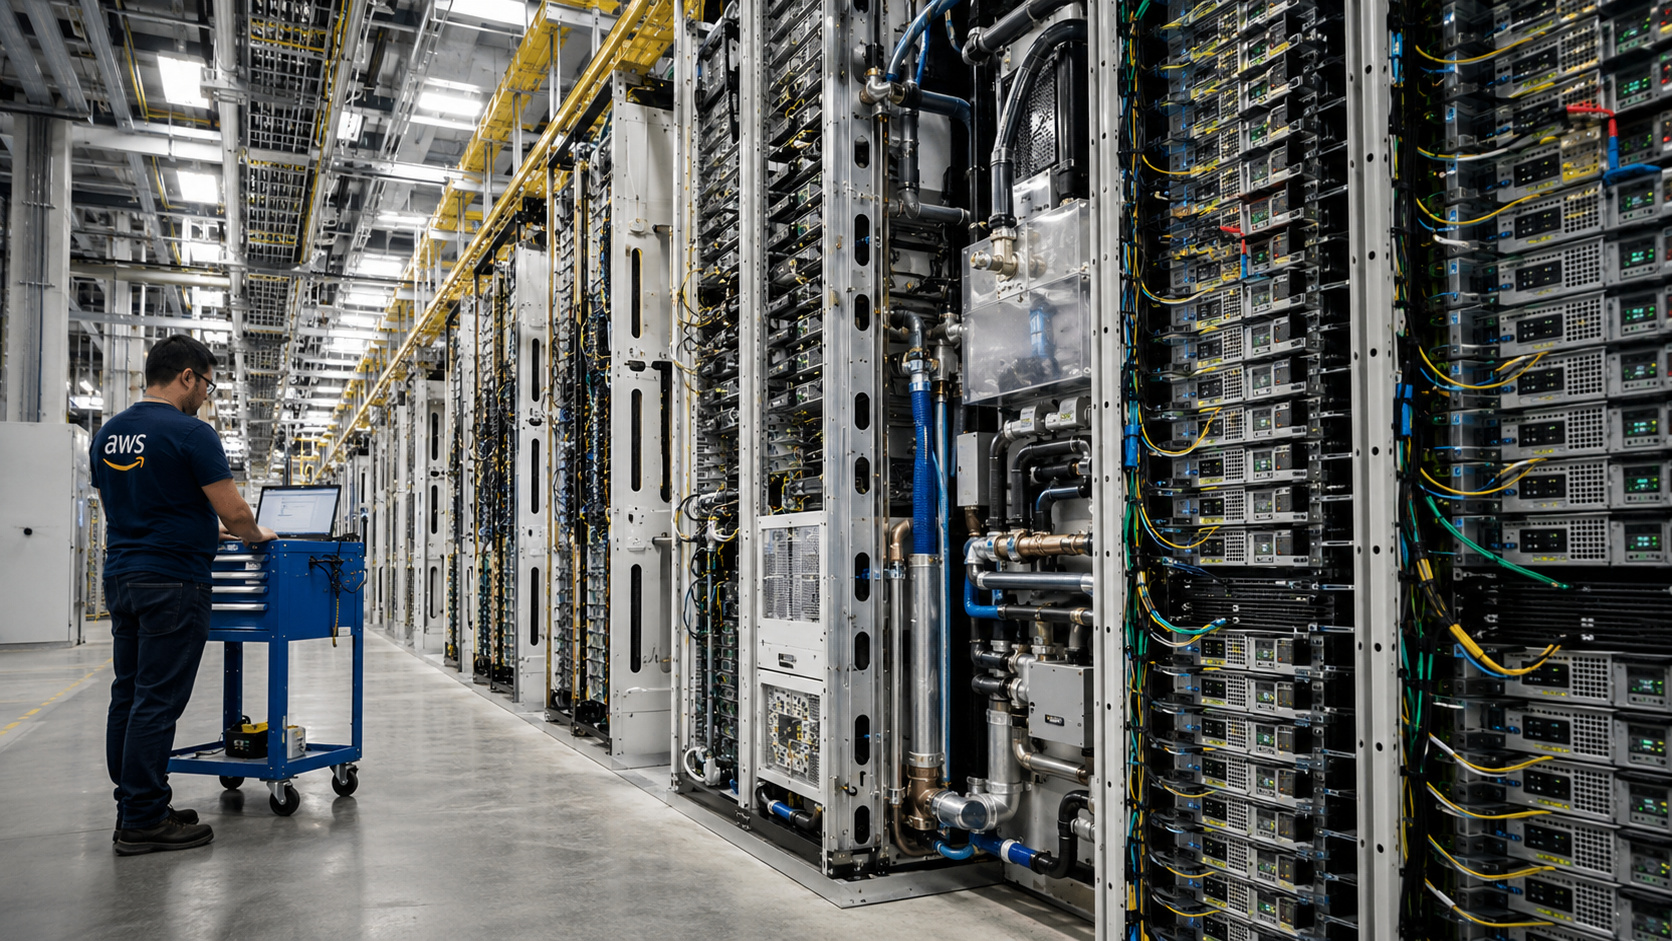
El anuncio apunta a un problema concreto y costoso: los balanceadores de carga por defecto de Kubernetes no ven el estado interno de las GPU, por lo que las solicitudes se acumulan detrás de pods ocupados mientras hay capacidad ociosa. AWS propone una capa de enrutamiento que sí lee esas señales y decide en tiempo real.
La promesa de reducir la latencia del primer token de 4,4 segundos a menos de 800 ms es una mejora de experiencia de usuario que puede traducirse directamente en retención y costos de infraestructura. Si se cumple en producción, cambia el cálculo de cuántas GPU se necesitan para un nivel de servicio dado.
El hecho de que se instale como un complemento gestionado de EKS sin tocar el código de la aplicación reduce la fricción de adopción. Eso puede acelerar la migración de cargas de inferencia hacia SageMaker HyperPod y presionar a otros proveedores de orquestación de GPU a ofrecer capacidades similares.
La lectura estratégica es que AWS está usando su posición en Kubernetes gestionado para diferenciar su pila de inferencia. No es solo un producto nuevo: es una forma de hacer más eficiente el recurso más caro del centro de datos y de amarrar a los clientes a su infraestructura.
Qué seguir
Habrá que observar benchmarks independientes y casos de uso en producción para validar la reducción de latencia y el impacto en la utilización de GPU.
Compartir esta historia
↗ Compartir
LinkedIn
WhatsApp
Copiar
RECIBE VIAMIND RADAR
Lo que importa, directo en tu correo.
Un resumen diario con una historia clave de cada sección.
Radar publica cada dia lo que cambia en tecnologia, telecomunicaciones e IA.
Sigue ViaMind Radar en LinkedIn ↗
← Volver al inicio
 ViaMind Radar