Un agente lento supera a uno rápido cuando el juego sigue corriendo
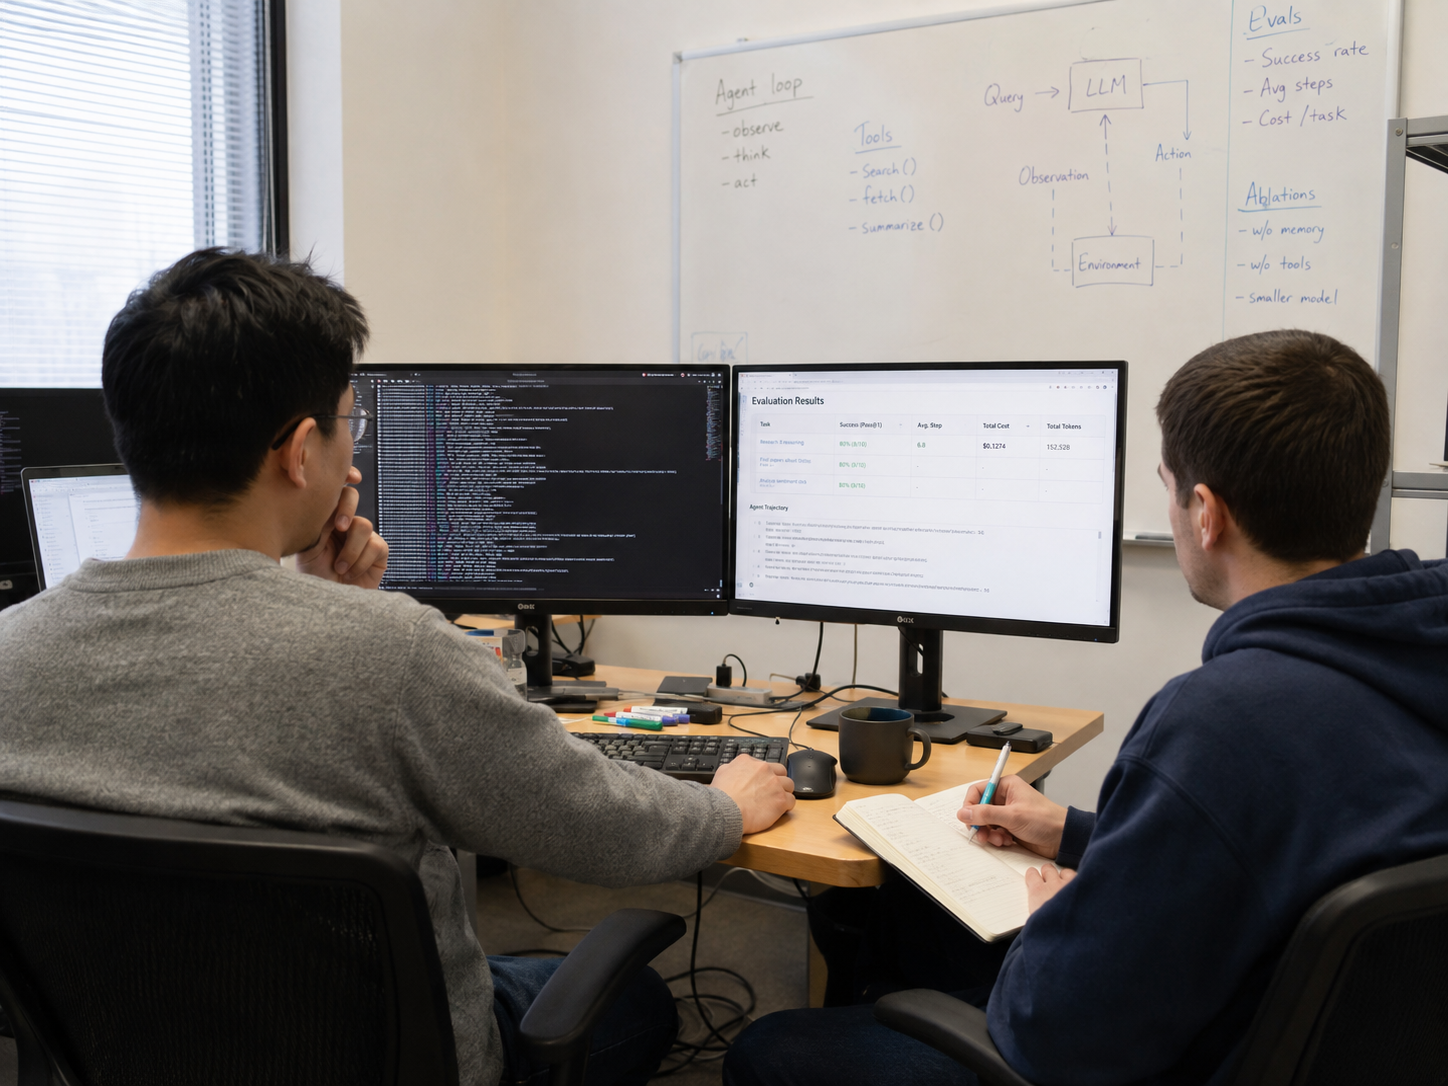
Investigadores de arXiv presentan RealtimeBench, un banco de pruebas con tareas en seis tipos de juegos que evalúa agentes de IA mientras el entorno cambia en tiempo real. El estudio muestra que un modelo más lento pero más capaz pierde frente a uno más rápido cuando las partidas no se pausan.
Ilustracion contextual ViaMind · no es fotografia del hecho
Lo reportado
El método TORSI
Según arXiv · cs.AI, el artículo propone Two-Timescale Offline Recursive Self-Improvement (TORSI): un profesor lento estudia fallos y prueba correcciones en juegos pausados entre intentos, y luego escribe instrucciones reutilizables para un estudiante rápido. El estudiante actúa sin llamadas al profesor durante el juego, y las puntuaciones de validación determinan qué actualizaciones se adoptan. Dos rondas elevan la puntuación media de Jev, mejorando los seis tipos de juego. Las instrucciones también mejoran las puntuaciones medias de otros tres modelos sin reajustarlos.
Estado de evidencia: ViaMind comprobó que las afirmaciones materiales publicadas están respaldadas por la evidencia enlazada. Esto no implica confirmación independiente de los hechos.
Qué seguir
Habrá que observar si los autores publican resultados en entornos más realistas o si otros equipos replican el enfoque en dominios como robótica o simulación de tráfico.
 ViaMind Radar